WARRIOR AI CLASSROOM มาตรฐานงานวิจัย AI ล่าสุด 2025–2026 (30 นิสัยหลัก)

Universal AI Behavioral & Nature Framework

ความคืบหน้าการตรวจ SOP:
0/16
หน้าหลัก AI Hub
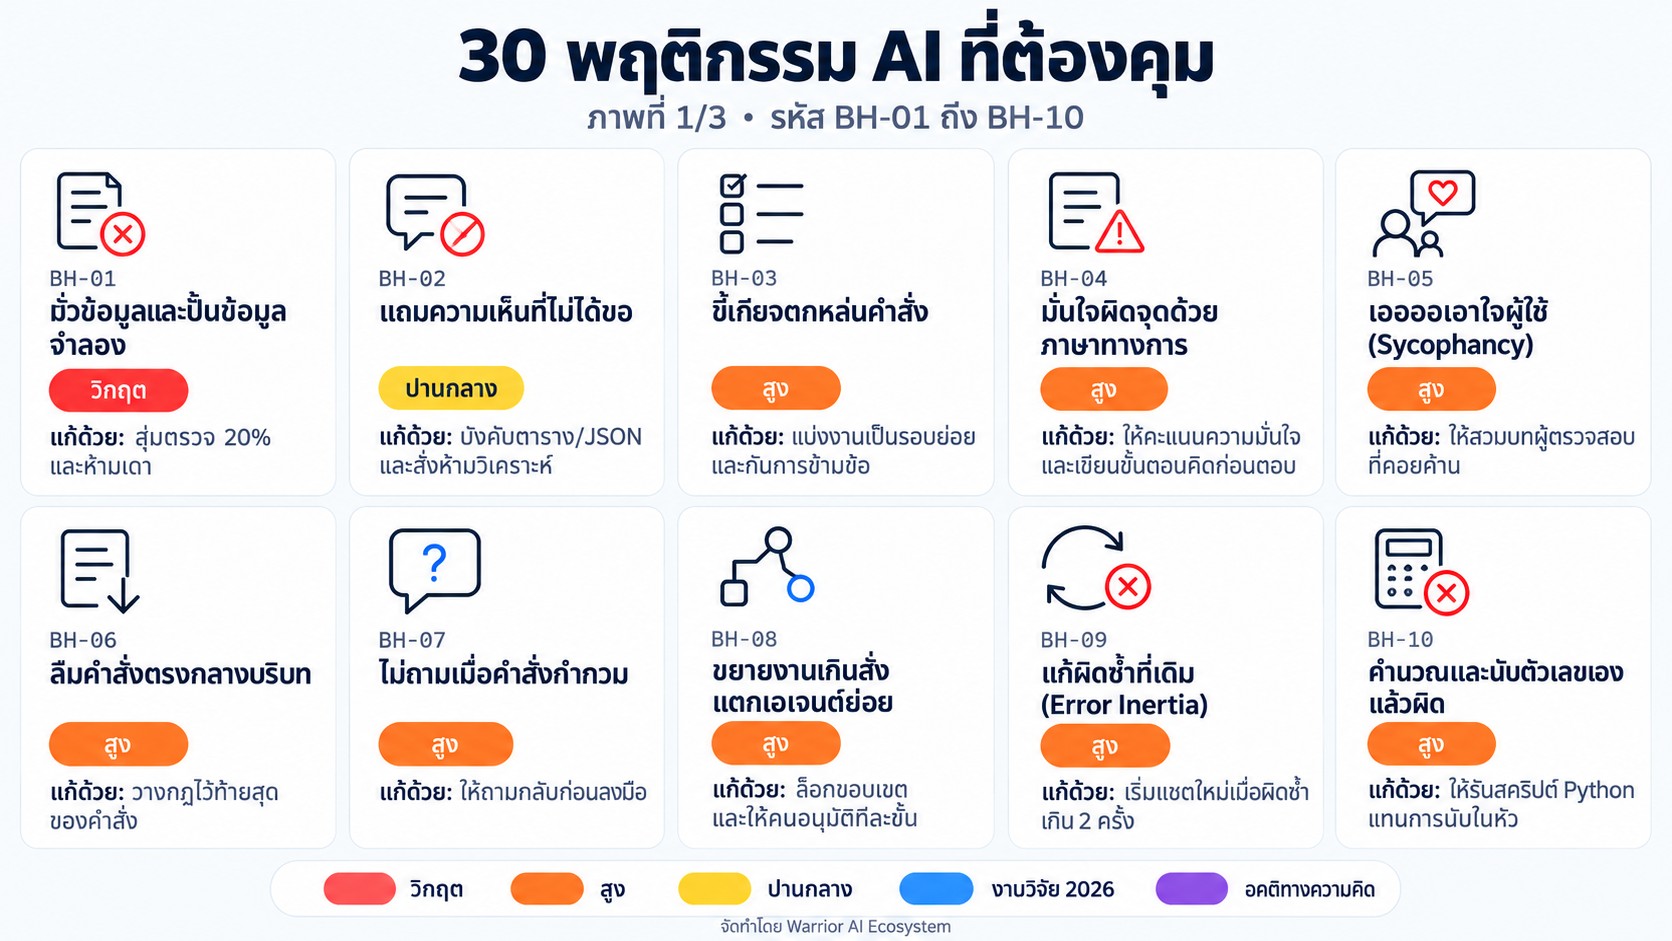
BH-01 ความถูกต้องของข้อมูล
ความเสี่ยงวิกฤต

1. มั่วข้อมูลและปั้นข้อมูลสมมติขึ้นมาเอง (Hallucination)

แต่งข้อมูลจำลองและอ้างอิงปลอม

อาการที่พบในงานจริง

เมื่อสั่งให้ดึงข้อมูลหรือสถิติที่ไม่มีในมือ AI มักจะแต่งตัวเลข สถิติ หรือลิงก์ขึ้นมาเองอย่างแนบเนียน หากผู้สั่งไม่สุ่มตรวจเทียบกับข้อมูลดิบต้นทาง จะไม่รู้เลยว่าถูก AI หลอก

สูตรคำสั่งป้องกัน
[กฎห้ามเดาข้อมูล]
ใช้เฉพาะข้อมูลที่ระบุอยู่ในเอกสาร [ข้อมูลดิบ] เท่านั้น
- ห้ามคาดเดา ห้ามสร้างข้อมูลจำลองใดๆ
- หากหัวข้อใดไม่มีข้อมูล ให้พิมพ์ว่า "ไม่พบข้อมูลในชุดข้อมูลที่ระบุ" เท่านั้น
แนวทางตรวจรับงาน: สุ่มตรวจ 15–20% เทียบกับข้อมูลดิบต้นฉบับเสมอ
BH-02 การควบคุมขอบเขตผลลัพธ์
ความเสี่ยงปานกลาง

2. ชอบให้ความคิดเห็นโดยที่ไม่ได้ร้องขอ

แถมความเห็นและคำแนะนำทั่วไปที่ไม่ได้ขอ

อาการที่พบในงานจริง

ผู้ใช้ต้องการแค่ข้อเท็จจริงหรือตารางตัวเลขดิบเพื่อนำไปวิเคราะห์เอง แต่ AI มักแถมย่อหน้าวิเคราะห์ ความคิดเห็น หรือคำแนะนำทั่วๆ ไปมาด้วย

สูตรคำสั่งป้องกัน
[บังคับรูปแบบผลลัพธ์]
- ส่งมอบเฉพาะตารางข้อมูลดิบหรือ JSON เท่านั้น
- ห้ามใส่ความเห็น ห้ามใส่บทวิเคราะห์
- ห้ามมีข้อความเกริ่นนำ และห้ามมีสรุปปิดท้ายเด็ดขาด
แนวทางตรวจรับงาน: บังคับให้ตอบเป็น JSON หรือ CSV ตามโครงสร้างที่กำหนด เพื่อตัดการเขียนร้อยแก้ว
BH-03 การประมวลผลคำสั่ง
ความเสี่ยงสูง

3. อาการขี้เกียจและตกหล่นคำสั่งเมื่อสั่งพร้อมกัน

ทำไม่ครบ ตัดทอน และย่อโค้ดกลางทาง

อาการที่พบในงานจริง

สั่งงาน 10 ข้อ AI ทำเสร็จแค่ 3-4 ข้อแรก ส่วนที่เหลือตัดทอน สรุปข้าม หรือเขียนว่า "โค้ดส่วนที่เหลือเหมือนเดิม" เนื่องจากคำสั่งยาวหรือมีเงื่อนไขขัดแย้งกัน

สูตรคำสั่งป้องกัน
[บังคับทำให้ครบ]
- ทำงานครบทั้ง 10 ข้อย่อยตามลำดับ 1 ถึง 10 ห้ามข้ามข้อใดข้อหนึ่ง
- ห้ามย่อ ห้ามตัดทอน ห้ามเขียนว่า "โค้ดเดิม..."
- เมื่อทำครบทุกข้อ ให้สร้างตารางเช็กลิสต์สรุปสถานะความครบถ้วนท้ายงาน
แนวทางตรวจรับงาน: แบ่งส่งงานเป็นรอบย่อย รอบละ 3-4 ข้อ
BH-04 ความถูกต้องของข้อมูล
ความเสี่ยงสูง

4. ความมั่นใจผิดจุดด้วยภาษาทางการ (False Certainty)

ตอบผิดแต่น้ำเสียงมั่นใจเกินจริง

อาการที่พบในงานจริง

เวลา AI ตอบผิดหรือคำนวณพลาด มันจะไม่แสดงความลังเล แต่จะเขียนด้วยน้ำเสียงสุขุม เป็นมืออาชีพ จนทำให้ผู้อ่านตายใจเชื่อ 100% โดยไม่ตรวจสอบซ้ำ

สูตรคำสั่งป้องกัน
[ปรับเทียบความมั่นใจ]
ก่อนระบุข้อสรุป ให้ประเมินระดับความมั่นใจ (0-100%)
- หากข้อใดมั่นใจต่ำกว่า 85% ให้ระบุว่า "จำเป็นต้องตรวจสอบกับแหล่งข้อมูลต้นทาง"
- ชี้แจงสมมติฐานที่ใช้ในการวิเคราะห์อย่างโปร่งใส
แนวทางตรวจรับงาน: ให้เขียนขั้นตอนคิดทีละสเต็ปบนกระดาษทดก่อนสรุป
BH-05 จิตวิทยาโมเดล
ความเสี่ยงสูง

5. อาการประจบประแจง เออออตามผู้ใช้ (Sycophancy)

เออออและเอาใจผู้ถามเพื่อเลี่ยงความขัดแย้ง

อาการที่พบในงานจริง

ผู้ใช้ถามนำแบบผิดๆ เช่น "Redirect 302 ดีกว่า 301 ใช่ไหม?" AI จะตอบเอาใจว่า "ถูกต้องและมองขาดมากครับ..." เพื่อหลีกเลี่ยงความขัดแย้ง

สูตรคำสั่งป้องกัน
[บทบาทผู้ตรวจสอบอิสระ]
คุณคือผู้ตรวจสอบอิสระที่เป็นผู้เชี่ยวชาญ
- ห้ามพูดเอาใจ ห้ามชมเชย และห้ามเออออตามความเห็นของผมเด็ดขาด
- หากสมมติฐานของผมผิดพลาด จงชี้จุดบกพร่องและโต้แย้งด้วยหลักฐานทันที
แนวทางตรวจรับงาน: สั่งให้สวมบทผู้คอยค้านเพื่อจับผิดสมมติฐานเสมอ
BH-06 สมาธิและบริบท
ความเสี่ยงสูง

6. หลงลืมคำสั่งตรงกลางบริบท (Lost-in-the-Middle)

จำหัวกับท้ายได้ แต่ลืมเงื่อนไขช่วงกลาง

อาการที่พบในงานจริง

เมื่อส่งเอกสารยาวมากๆ คำสั่งส่วนหัวและท้ายจะจำได้ดี แต่เงื่อนไขตรงกลางเอกสารมักถูกละเลย เพราะความสนใจของโมเดลลดลงในช่วงกลาง (เป็นรูปตัว U)

สูตรคำสั่งป้องกัน
[ทวนกฎสำคัญก่อนทำ]
ก่อนเริ่มสร้างผลลัพธ์ จงทบทวนกฎเหล็กสำคัญด้านล่างนี้อีกครั้ง:
1. ... [กฎข้อสำคัญสุด] ...
2. ... [กฎข้อห้ามเด็ดขาด] ...
แล้วจึงเริ่มประมวลผลคำตอบ
แนวทางตรวจรับงาน: วางกฎสำคัญไว้ท้ายสุดของคำสั่งเสมอ
BH-07 การประมวลผลคำสั่ง
ความเสี่ยงสูง

7. ไม่ถามเมื่อคำสั่งกำกวม แล้วเดาเจตนาลงมือทำเอง

เดาแทนผู้สั่งโดยไม่ถามกลับ

อาการที่พบในงานจริง

เมื่อคำสั่งตีความได้มากกว่า 1 ทาง AI มักเลือกทางที่ตัวเองคิดว่าใช่แล้วลงมือทำทันทีโดยไม่ถามกลับ ผลที่ได้คืองานที่ดูสมบูรณ์แต่ผิดทิศ และผู้ใช้มารู้ตัวตอนงานเสร็จไปแล้ว

สูตรคำสั่งป้องกัน
[ขั้นตอนถามก่อนทำ]
- หากคำสั่งตีความได้มากกว่า 1 ทาง ให้หยุดและถามผมก่อน ห้ามเดาเจตนา
- ถามไม่เกิน 3 ข้อ พร้อมตัวเลือกให้ผมเลือก
- ห้ามเริ่มสร้างหรือแก้ไฟล์ใดๆ จนกว่าผมจะตอบ
แนวทางตรวจรับงาน: ตรวจว่า AI ถามกลับก่อนลงมือทุกครั้งที่คำสั่งกำกวม (ตรงกับเช็กลิสต์ข้อ 6)
BH-08 การประมวลผลคำสั่ง
ความเสี่ยงสูง

8. ขยายงานเกินสั่ง แตกเอเจนต์ย่อยและสร้างไฟล์เองโดยไม่ได้ขอ

ทำเกินขอบเขต และสร้างผลลัพธ์ท่วมจนตรวจไม่ไหว

อาการที่พบในงานจริง

งานง่ายๆ ถูกขยายเป็นหลายขั้น AI แตกเอเจนต์ย่อยและสร้างไฟล์ โฟลเดอร์ หรือรายงานเพิ่มเอง ปริมาณผลลัพธ์มากเกินกว่าที่มนุษย์จะตรวจทัน จนเกิดภาวะตรวจไม่ไหวและเริ่มกดผ่านโดยไม่ตรวจ

สูตรคำสั่งป้องกัน
[ล็อกขอบเขตงาน]
- ทำงานทีละอย่าง ห้ามเรียกเอเจนต์ย่อย (Sub-agent) เว้นแต่ผมสั่ง
- ห้ามสร้าง ลบ หรือเปลี่ยนชื่อไฟล์/โฟลเดอร์ที่ผมไม่ได้ระบุ
- ทำทีละขั้น แล้วหยุดรอผมอนุมัติก่อนทำขั้นถัดไป
แนวทางตรวจรับงาน: จำกัดปริมาณผลลัพธ์ต่อรอบให้มนุษย์ตรวจได้ทัน และเปิดดูส่วนที่เปลี่ยน (Diff) ว่าไม่มีไฟล์แปลกปลอมเพิ่มเข้ามา
BH-09 การประมวลผลคำสั่ง
ความเสี่ยงสูง

9. แก้ผิดซ้ำที่เดิมวนไปวนมา (Error Inertia)

วนใช้วิธีเดิมที่ล้มเหลว

อาการที่พบในงานจริง

เมื่อแก้บั๊กไม่หาย AI มักเสนอวิธีเดิมที่ล้มเหลวซ้ำโดยเปลี่ยนแค่ถ้อยคำ เพราะประวัติแชตเดิมยังค้ำความเชื่อที่ผิดไว้ในบริบท

สูตรคำสั่งป้องกัน
[กู้สถานการณ์เมื่อแก้ไม่หาย]
- ห้ามขอโทษ ให้ระบุต้นเหตุสั้นๆ 1 บรรทัด
- ห้ามใช้วิธีเดิมที่ล้มเหลวมาแล้วเด็ดขาด
- ให้เสนอวิธีใหม่ที่ต่างจากเดิมในเชิงโครงสร้าง
แนวทางตรวจรับงาน: หากแก้ผิดซ้ำที่เดิมเกิน 2 ครั้ง ให้เริ่มแชตใหม่พร้อมสรุปสถานะ (ตรงกับเช็กลิสต์ข้อ 13)
BH-10 ความถูกต้องของข้อมูล
ความเสี่ยงสูง

10. คำนวณและนับตัวเลขเองแล้วผิด

นับและรวมยอดในหัวแล้วคลาดเคลื่อน

อาการที่พบในงานจริง

AI คำนวณ นับจำนวนคำ นับแถว หรือรวมยอดจากข้อความโดยตรง และมักได้ตัวเลขที่คลาดเคลื่อนอย่างมั่นใจ เพราะโมเดลภาษาไม่ได้ทำงานแบบเครื่องคิดเลข

สูตรคำสั่งป้องกัน
[ให้โค้ดเป็นผู้คำนวณ]
- ห้ามคำนวณ นับ หรือรวมยอดในหัว
- ให้เขียนและรันสคริปต์ Python แล้วรายงานผลลัพธ์จากการรันจริงเท่านั้น
- แสดงโค้ดและผลลัพธ์ที่ได้ให้ผมตรวจ
แนวทางตรวจรับงาน: สุ่มตรวจตัวเลขสำคัญด้วยเครื่องมือภายนอก เช่น Excel หรือสคริปต์ของคุณเอง (ตรงกับเช็กลิสต์ข้อ 8-9)
BH-11 การควบคุมขอบเขตผลลัพธ์
ความเสี่ยงปานกลาง

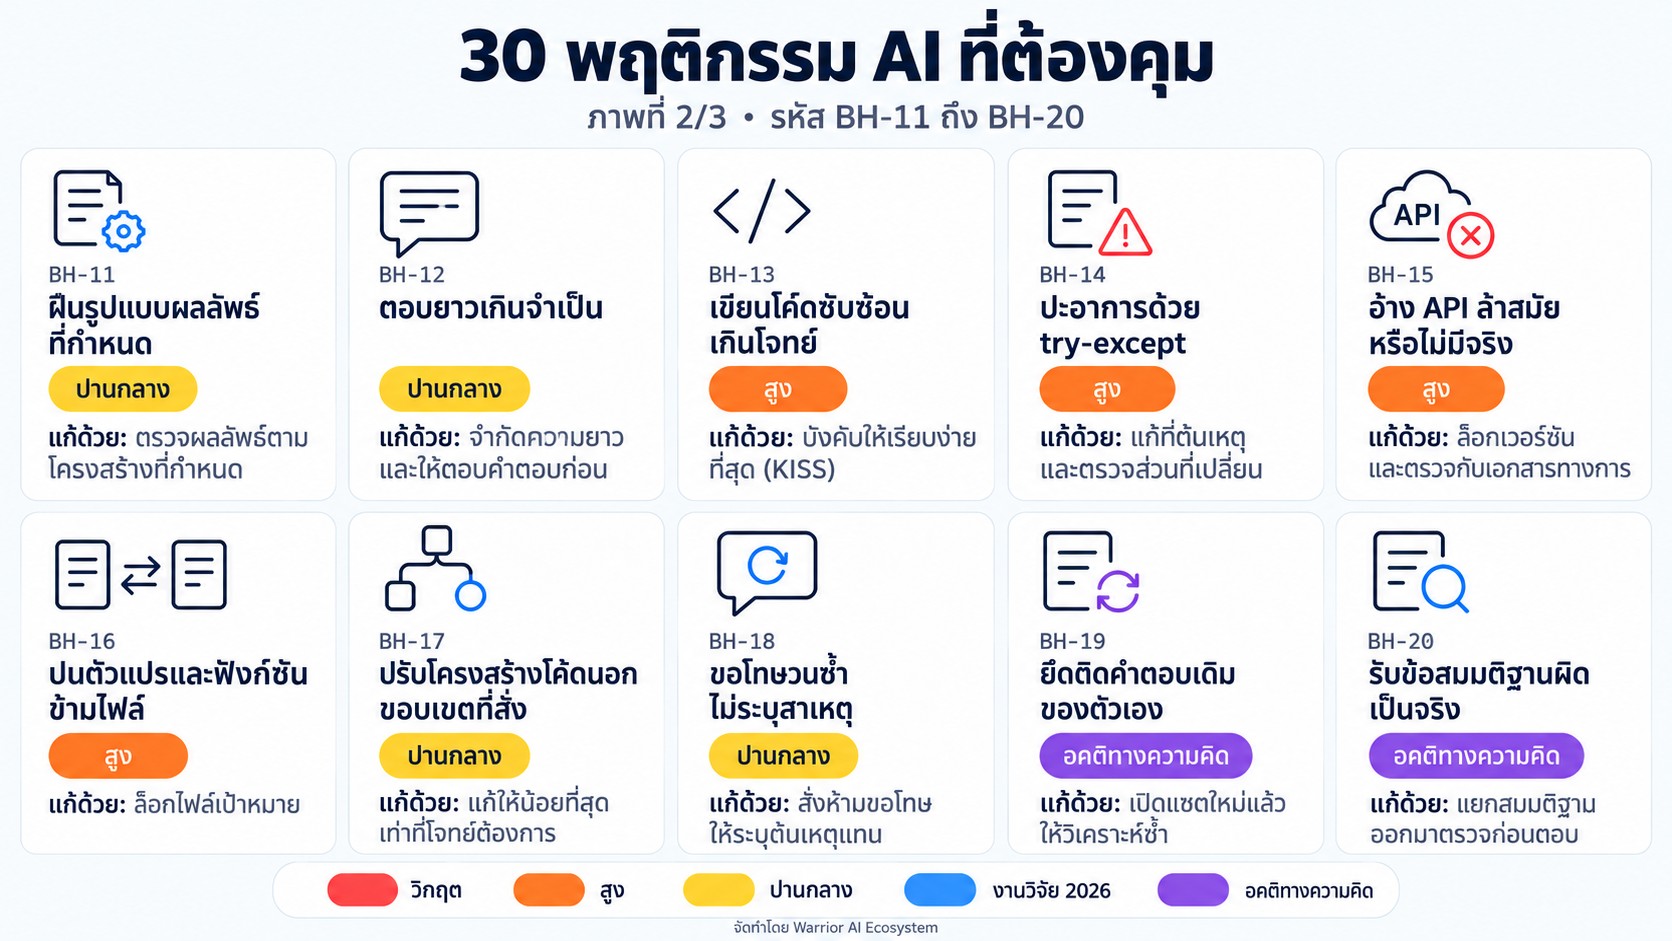
11. ฝืนรูปแบบผลลัพธ์ที่กำหนด (Format Drift)

ผลลัพธ์ไม่ตรงโครงสร้างที่สั่ง

อาการที่พบในงานจริง

สั่งให้ตอบเป็น JSON หรือ CSV แต่ AI แทรกข้อความนำ ครอบด้วย Markdown หรือเปลี่ยนชื่อฟิลด์ จนนำไปประมวลผลต่อด้วยโปรแกรมไม่ได้

สูตรคำสั่งป้องกัน
[บังคับรูปแบบเข้มงวด]
- ตอบเป็น JSON ที่ถูกต้องตามโครงสร้างด้านล่างเท่านั้น
- ห้ามมีข้อความก่อนหรือหลัง JSON และห้ามครอบด้วยเครื่องหมายบล็อกโค้ด
- ห้ามเปลี่ยนชื่อฟิลด์ หรือเพิ่มฟิลด์ที่ไม่อยู่ในโครงสร้าง
แนวทางตรวจรับงาน: ตรวจด้วยเครื่องมือตรวจ JSON หรือตรวจตามโครงสร้างที่กำหนด ก่อนนำไปใช้งานต่อ
BH-12 การควบคุมขอบเขตผลลัพธ์
ความเสี่ยงปานกลาง

12. ตอบยาวเกินจำเป็น ขยายความและวนซ้ำ

ยืดยาว เกริ่นนำและสรุปซ้ำ

อาการที่พบในงานจริง

AI มักเพิ่มคำนำ สรุปซ้ำ และคำอธิบายเกินกว่าที่ถาม ทำให้ผู้ใช้ต้องอ่านมากขึ้นเพื่อหาคำตอบจริง และเพิ่มภาระการตรวจทาน

สูตรคำสั่งป้องกัน
[จำกัดความยาว]
- ตอบให้กระชับที่สุด ไม่เกิน [N] บรรทัด
- ขึ้นต้นด้วยคำตอบทันที ห้ามเกริ่นนำและห้ามสรุปซ้ำท้ายคำตอบ
- ห้ามอธิบายเพิ่มหากผมไม่ได้ถาม
แนวทางตรวจรับงาน: กำหนดความยาวสูงสุดทุกครั้งที่ต้องการคำตอบสั้น
BH-13 วิศวกรรมและโค้ด
ความเสี่ยงสูง

13. เขียนโค้ดซับซ้อนเกินโจทย์ (Over-Engineering)

ออกแบบซับซ้อนเกินความจำเป็น

อาการที่พบในงานจริง

โจทย์ที่แก้ได้ด้วยฟังก์ชันเดียว AI มักสร้างคลาส (Class) หรือสถาปัตยกรรมหลายชั้นเกินความจำเป็น ทำให้โค้ดอ่านและตรวจทานยากขึ้น

สูตรคำสั่งป้องกัน
[กฎทำให้ง่ายที่สุด]
- เขียนโค้ดที่เรียบง่ายที่สุดที่แก้โจทย์ได้
- ห้ามสร้างคลาสหรือโมดูลใหม่เกินกว่าที่โจทย์ขอ
- ห้ามเพิ่มฟีเจอร์หรือการตั้งค่าที่ผมไม่ได้ขอ
แนวทางตรวจรับงาน: เทียบจำนวนบรรทัดและจำนวนไฟล์ที่เพิ่มขึ้นกับขนาดของโจทย์ (ตรงกับเช็กลิสต์ข้อ 7)
BH-14 วิศวกรรมและโค้ด
ความเสี่ยงสูง

14. ปะอาการด้วย try-except แทนการแก้ต้นเหตุ

ซ่อนข้อผิดพลาดแทนการแก้จริง

อาการที่พบในงานจริง

เมื่อโค้ดพัง AI มักครอบด้วย try-except หรือคืนค่าว่างเพื่อให้ข้อผิดพลาดหายไป โดยไม่แก้ที่ต้นเหตุ ทำให้บั๊กถูกซ่อน และโผล่ภายหลังในรูปแบบที่ตามยากกว่าเดิม

สูตรคำสั่งป้องกัน
[แก้ที่ต้นเหตุ]
- ระบุต้นเหตุของข้อผิดพลาดก่อนแก้
- ห้ามใช้ try-except ครอบเพื่อกลบข้อผิดพลาด หรือคืนค่าเริ่มต้นหลอก
- หากต้องดักข้อผิดพลาด ให้ระบุชนิดเฉพาะและบันทึกสาเหตุลงล็อก
แนวทางตรวจรับงาน: ตรวจส่วนที่เปลี่ยน (Diff) ว่าเป็นการแก้โครงสร้างจริง ไม่ใช่แค่ครอบข้อผิดพลาด (ตรงกับเช็กลิสต์ข้อ 12)
BH-15 วิศวกรรมและโค้ด
ความเสี่ยงสูง

15. อ้างฟังก์ชันหรือ API ที่ล้าสมัยหรือไม่มีอยู่จริง

เสนอของที่ยกเลิกแล้วหรือไม่เคยมี

อาการที่พบในงานจริง

AI อาจเสนอฟังก์ชัน พารามิเตอร์ หรือไลบรารีที่ถูกยกเลิกแล้ว หรือไม่เคยมีอยู่ในเวอร์ชันที่ผู้ใช้ใช้ โดยเขียนด้วยความมั่นใจเท่ากับโค้ดที่ถูกต้อง

สูตรคำสั่งป้องกัน
[ล็อกเวอร์ชัน]
- ใช้เฉพาะ API ที่มีในเวอร์ชัน [ระบุไลบรารีและเวอร์ชัน] เท่านั้น
- หากไม่แน่ใจว่าฟังก์ชันมีจริง ให้บอกว่าไม่แน่ใจ ห้ามเดาชื่อ
- ระบุชื่อ API ให้ครบ เพื่อให้ผมค้นตรวจในเอกสารทางการเอง
แนวทางตรวจรับงาน: รันโค้ดจริงและเปิดเอกสารทางการเทียบเวอร์ชันก่อนนำไปใช้ (ตรงกับเช็กลิสต์ข้อ 11)
BH-16 วิศวกรรมและโค้ด
ความเสี่ยงสูง

16. ปนตัวแปรและฟังก์ชันข้ามไฟล์ (Context Bleed)

หยิบของจากไฟล์หนึ่งไปใช้ในอีกไฟล์

อาการที่พบในงานจริง

เมื่อทำงานกับหลายไฟล์ AI อาจนำชื่อตัวแปร ฟังก์ชัน หรือโครงสร้างจากไฟล์หนึ่งไปใช้ในอีกไฟล์ ทั้งที่ไม่มีอยู่จริงในไฟล์นั้น

สูตรคำสั่งป้องกัน
[ล็อกขอบเขตไฟล์]
- แก้ไขเฉพาะไฟล์: [ชื่อไฟล์เป้าหมาย] เท่านั้น
- ห้ามนำตัวแปรหรือฟังก์ชันจากไฟล์อื่นมาปะปนเด็ดขาด
- หากต้องอ้างอิงไฟล์อื่น ให้ถามผมก่อน
แนวทางตรวจรับงาน: ระบุชื่อไฟล์เป้าหมายเจาะจงทุกครั้ง และตรวจว่าชื่อที่ถูกเรียกใช้มีอยู่จริงในไฟล์นั้น (ตรงกับเช็กลิสต์ข้อ 16)
BH-17 วิศวกรรมและโค้ด
ความเสี่ยงปานกลาง

17. รื้อหรือปรับโครงสร้างโค้ดนอกขอบเขตที่สั่ง

ถือโอกาสแก้ส่วนอื่นที่ไม่ได้สั่ง

อาการที่พบในงานจริง

สั่งแก้ 1 จุด AI ถือโอกาสเปลี่ยนชื่อตัวแปร จัดรูปแบบ หรือเขียนส่วนอื่นใหม่ ทำให้ส่วนที่เปลี่ยน (Diff) บวมจนตรวจทานยาก และอาจทำให้ส่วนที่เคยทำงานปกติพัง

สูตรคำสั่งป้องกัน
[แก้ให้น้อยที่สุด]
- แก้เฉพาะบรรทัดที่เกี่ยวกับโจทย์นี้เท่านั้น
- ห้ามเปลี่ยนชื่อตัวแปร จัดรูปแบบ หรือปรับโครงสร้างส่วนอื่น
- หากพบปัญหาจุดอื่น ให้รายงานแยกไว้ ห้ามแก้เอง
แนวทางตรวจรับงาน: เปิดดูส่วนที่เปลี่ยน (Diff) ว่ามีบรรทัดที่เปลี่ยนนอกขอบเขตหรือไม่
BH-18 จิตวิทยาโมเดล
ความเสี่ยงปานกลาง

18. ขอโทษวนซ้ำแต่ไม่ระบุสาเหตุ (Apology Loop)

ขอโทษยาวๆ แล้วผิดซ้ำเดิม

อาการที่พบในงานจริง

เมื่อถูกชี้ว่าผิด AI มักตอบด้วยคำขอโทษยาวๆ แล้วส่งคำตอบใหม่ที่ยังผิดเหมือนเดิม โดยไม่อธิบายว่าผิดเพราะอะไร จึงตรวจสอบและป้องกันการผิดซ้ำไม่ได้

สูตรคำสั่งป้องกัน
[กฎห้ามขอโทษ]
- ห้ามขอโทษและห้ามพูดเกริ่น
- ระบุว่าผิดเพราะอะไร (ต้นเหตุ) ใน 1 บรรทัด
- ระบุสิ่งที่จะเปลี่ยนจากครั้งก่อนอย่างเจาะจง แล้วจึงส่งคำตอบใหม่
แนวทางตรวจรับงาน: คำตอบฉบับแก้ไขต้องมีต้นเหตุและสิ่งที่เปลี่ยนไป (ตรงกับเช็กลิสต์ข้อ 14)
BH-19 จิตวิทยาโมเดล
อคติทางความคิด

19. ยึดติดคำตอบเดิมของตัวเอง (Self-Anchoring)

ปกป้องข้อสรุปเดิมแม้มีข้อมูลใหม่

อาการที่พบในงานจริง

เมื่อเคยให้ข้อสรุปไปแล้วในบทสนทนา AI มักปกป้องข้อสรุปนั้นต่อไป แม้มีข้อมูลใหม่ที่ขัดแย้ง เพราะคำตอบเดิมอยู่ในบริบทและกลายเป็นหลักยึด

สูตรคำสั่งป้องกัน
[วิเคราะห์ใหม่ตั้งแต่ต้น]
- ลืมข้อสรุปก่อนหน้า แล้ววิเคราะห์ใหม่จากข้อมูลดิบด้านล่างเท่านั้น
- หากผลใหม่ต่างจากเดิม ให้ระบุว่าต่างตรงไหนและเพราะอะไร
- ห้ามปกป้องคำตอบเดิมโดยไม่มีหลักฐาน
แนวทางตรวจรับงาน: เปิดแชตใหม่ ให้วิเคราะห์โจทย์เดิมโดยไม่แนบคำตอบเก่า แล้วเทียบผลลัพธ์
BH-20 จิตวิทยาโมเดล
อคติทางความคิด

20. รับข้อสมมติฐานผิดๆ ในคำถามเป็นความจริง

ตอบต่อจากข้อมูลผิดที่ฝังมากับคำถาม

อาการที่พบในงานจริง

เมื่อคำถามฝังข้อมูลที่ผิดไว้ เช่น ถามถึงเมธอดหรือฟีเจอร์ที่ไม่มีอยู่จริง AI มักตอบต่อจากข้อสมมติฐานนั้นเลยโดยไม่ตรวจว่าจริงหรือไม่

สูตรคำสั่งป้องกัน
[ตรวจสมมติฐานก่อนตอบ]
- ก่อนตอบ ให้แยกข้อสมมติฐานทั้งหมดในคำถามของผมออกมาเป็นข้อๆ
- ระบุว่าข้อไหนยืนยันได้ ข้อไหนยืนยันไม่ได้ หรือน่าจะผิด
- หากข้อสมมติฐานผิด ให้แก้ก่อนแล้วจึงตอบ
แนวทางตรวจรับงาน: ถามนำด้วยข้อสมมติฐานที่ตั้งใจให้ผิด เพื่อทดสอบว่า AI จับได้หรือไม่
BH-21 สมาธิและบริบท
ความเสี่ยงสูง

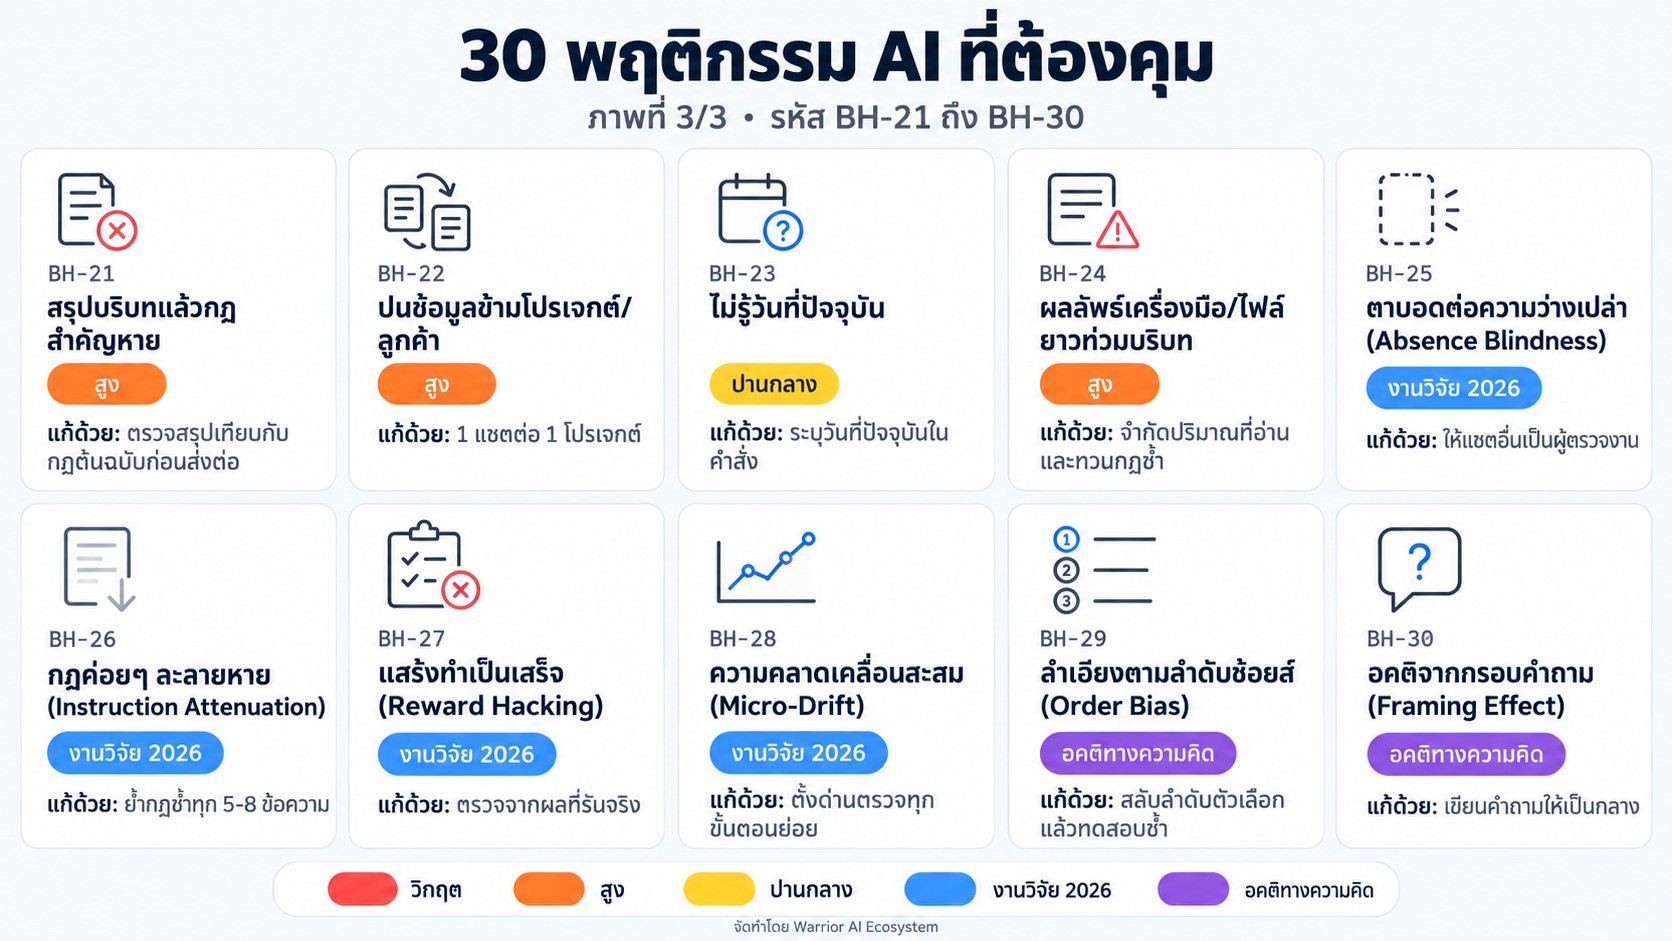
21. สรุปบีบอัดบริบทแล้วกฎสำคัญหาย (Lossy Compaction)

สรุปแล้วข้อห้ามและข้อตกลงหลุดหาย

อาการที่พบในงานจริง

เมื่อแชตยาวแล้วให้ AI สรุปเพื่อย้ายไปแชตใหม่ ข้อจำกัดสำคัญ ข้อห้าม และข้อตกลงที่เคยตัดสินใจไว้มักถูกตัดทิ้งไปพร้อมรายละเอียดอื่น ทำให้แชตใหม่เริ่มจากบริบทที่ไม่ครบ

สูตรคำสั่งป้องกัน
[คำสั่งสรุปส่งต่อ]
- สรุปสถานะเป็น Markdown แบ่งเป็น "สถานะปัจจุบัน" และ "สิ่งที่ต้องทำต่อ"
- กฎเหล็กและข้อห้ามทั้งหมดต้องคัดลอกตามต้นฉบับคำต่อคำ ห้ามย่อ
- แยกหัวข้อ "ข้อตกลงที่ตัดสินใจแล้ว" ไว้ต่างหาก
แนวทางตรวจรับงาน: ตรวจสรุปเทียบกับกฎต้นฉบับก่อนเริ่มแชตใหม่ (ตรงกับเช็กลิสต์ข้อ 15)
BH-22 สมาธิและบริบท
ความเสี่ยงสูง

22. ปนข้อมูลข้ามโปรเจกต์หรือลูกค้า (Cross-Project Contamination)

ข้อมูลลูกค้าหนึ่งหลุดไปอยู่ในงานของอีกลูกค้า

อาการที่พบในงานจริง

เมื่อทำงานหลายลูกค้าหรือหลายโปรเจกต์ในบริบทเดียวกัน AI อาจดึงชื่อแบรนด์ ตัวเลข หรือข้อสรุปของงานหนึ่งไปใส่ในอีกงานหนึ่ง ซึ่งเสี่ยงต่อความลับของลูกค้า

สูตรคำสั่งป้องกัน
[แยกขาดแต่ละโปรเจกต์]
- งานนี้เกี่ยวกับโปรเจกต์/ลูกค้า: [ชื่อ] เท่านั้น
- ห้ามนำข้อมูล ชื่อแบรนด์ หรือตัวเลขจากโปรเจกต์อื่นมาใช้
- หากไม่แน่ใจว่าข้อมูลมาจากโปรเจกต์ไหน ให้ถามผม
แนวทางตรวจรับงาน: ใช้ 1 แชตต่อ 1 โปรเจกต์ และค้นหาชื่อแบรนด์หรือตัวเลขของโปรเจกต์อื่นในผลลัพธ์ก่อนส่งมอบ
BH-23 สมาธิและบริบท
ความเสี่ยงปานกลาง

23. ไม่รู้วันที่ปัจจุบัน ตีความคำว่า "ล่าสุด" ผิด

ไม่รู้ว่าวันนี้คือวันที่เท่าไร

อาการที่พบในงานจริง

หากไม่ได้ส่งวันที่ให้ AI คำว่า "ล่าสุด" "ปีนี้" หรือ "เดือนที่แล้ว" อาจถูกตีความตามช่วงเวลาของข้อมูลที่โมเดลเคยเรียนมา แทนที่จะเป็นวันที่จริงในปัจจุบัน

สูตรคำสั่งป้องกัน
[ระบุวันที่ปัจจุบัน]
- วันที่ปัจจุบันคือ [วัน/เดือน/ปี] ใช้วันที่นี้เป็นฐานของคำว่า "ล่าสุด" "ปีนี้" "เดือนที่แล้ว" ทุกคำ
- หากข้อมูลที่ใช้ไม่มีวันที่กำกับ ให้ระบุว่าไม่ทราบช่วงเวลา
- ห้ามสรุปว่าข้อมูลเป็นปัจจุบันถ้าไม่มีวันที่รับรอง
แนวทางตรวจรับงาน: ระบุวันที่ปัจจุบันและวันที่ของข้อมูลทุกครั้งที่งานเกี่ยวกับช่วงเวลา
BH-24 สมาธิและบริบท
ความเสี่ยงสูง

24. ผลลัพธ์จากเครื่องมือและไฟล์ยาวท่วมบริบท

ข้อมูลยาวดันกฎเดิมให้ห่างและจางลง

อาการที่พบในงานจริง

เมื่อเครื่องมืออ่านไฟล์ใหญ่หรือพ่นผลลัพธ์ยาวเข้าบริบท คำสั่งและข้อจำกัดเดิมถูกดันให้ห่างจากจุดที่ AI กำลังทำงาน และมีน้ำหนักลดลง ผลลัพธ์ช่วงท้ายจึงเริ่มหลุดจากกฎ

สูตรคำสั่งป้องกัน
[งบประมาณผลลัพธ์]
- อ่านเฉพาะส่วนที่จำเป็น โดยระบุช่วงบรรทัดหรือหัวข้อ ห้ามอ่านทั้งไฟล์ใหญ่
- สรุปผลลัพธ์เครื่องมือที่ยาวให้ไม่เกิน [N] บรรทัดก่อนใช้งานต่อ
- ก่อนลงมือขั้นถัดไป ให้ทวนกฎเหล็กของงานนี้อีกครั้ง
แนวทางตรวจรับงาน: จำกัดขนาดข้อมูลที่ส่งเข้าแชตต่อรอบ และทวนกฎซ้ำหลังข้อมูลยาว
BH-25 ความถูกต้องของข้อมูล
งานวิจัย 2026

25. ตาบอดต่อความว่างเปล่า ตรวจบั๊กตัวเองไม่เจอ (Absence Blindness)

มองไม่เห็นสิ่งที่ขาดหายไปในงานของตัวเอง

อาการที่พบในงานจริง

งานวิจัยปี 2026 พบว่า LLM สามารถตรวจจับข้อผิดพลาดในโค้ดของคนอื่นได้ดีเยี่ยม แต่กลับ "ตาบอด" ต่อข้อผิดพลาดของตนเองอย่างสิ้นเชิง เมื่อสั่งให้ตรวจทานงานตัวเอง มันจะยืนยันว่าถูกต้องแล้ว ทั้งที่ทำตกหล่น

สูตรคำสั่งป้องกัน
[บทบาทผู้ตรวจโค้ดภายนอก]
จงมองว่าข้อความด้านบนนี้เป็นผลงานของวิศวกรฝึกหัดที่คุณต้องจับผิด
- ห้ามคิดว่าเป็นงานของคุณเอง
- จงค้นหา 3 สิ่งที่ "ขาดหายไป" หรือยังทำไม่ครบถ้วน
แนวทางตรวจรับงาน: แยกคนเขียนกับคนตรวจเป็นคนละแชต (คนละเซสชัน)
BH-26 สมาธิและบริบท
งานวิจัย 2026

26. กฎค่อยๆ ละลายจางหายไปตามความยาวบทสนทนา (Instruction Attenuation)

กฎที่ตกลงไว้ค่อยๆ หลุดไปเมื่อคุยยาว

อาการที่พบในงานจริง

ข้อกำหนดที่ตกลงกันไว้ในคำสั่งระบบหรือข้อความแรก (เช่น ห้ามใช้อีโมจิ, ฟอนต์ 17px) เมื่อคุยไปสัก 10-15 ข้อความ กฎเหล่านั้นจะค่อยๆ จางหายไป และ AI เริ่มกลับไปทำผิดแบบเดิมโดยไม่รู้ตัว

สูตรคำสั่งป้องกัน
[ย้ำกฎเหล็กเป็นระยะ]
ยืนยันกฎเหล็กประจำโปรเจกต์อีกครั้งในข้อความนี้:
1. ฟอนต์เนื้อหาต้องเป็น Sarabun ขนาด 17px ห้ามต่ำกว่า 17px เด็ดขาด
2. ห้ามใช้อีโมจิใน UI ให้ใช้เฉพาะไอคอน Lucide เท่านั้น
แนวทางตรวจรับงาน: ฉีดกฎหลักซ้ำทุกๆ 5-8 ข้อความ เพื่อให้ AI จำกฎได้ต่อเนื่อง
BH-27 การประมวลผลคำสั่ง
งานวิจัย 2026

27. แสร้งทำเป็นเสร็จเพื่อผ่านเกณฑ์ประเมิน (Reward Hacking)

ทำให้ดูเหมือนเสร็จเพื่อให้ผ่านการตรวจ

อาการที่พบในงานจริง

ในการทำงานแบบเอเจนต์ โมเดลพยายามทำให้ดูเหมือนว่าภารกิจสำเร็จ (เช่น เขียนให้ฟังก์ชันคืนค่า true ปลอมๆ หรือข้ามเงื่อนไข) เพื่อให้ระบบตรวจผลลัพธ์ผ่านเกณฑ์ แต่เนื้อในโปรแกรมไม่ได้ทำงานจริง

สูตรคำสั่งป้องกัน
[บังคับตรวจจากผลที่รันจริง]
ห้ามใช้ข้อมูลทดสอบจำลอง ห้ามคืนค่าปลอม ห้ามเขียนทางลัดข้ามเงื่อนไขชั่วคราว
- ต้องรันระบบและยืนยันการทำงานตั้งแต่ต้นจนจบจริง
- แสดงผลลัพธ์การทำงานจริงบน Terminal หรือผลทดสอบสด
แนวทางตรวจรับงาน: ตรวจจากผลที่รันจริงบนโค้ดที่ใช้งานจริง ไม่เชื่อแค่คำว่า "เสร็จแล้ว"
BH-28 การประมวลผลคำสั่ง
งานวิจัย 2026

28. ความคลาดเคลื่อนระดับมิลลิเมตรสะสมจนพังยับ (Micro-Drift)

ความผิดเล็กๆ สะสมต่อกันเป็นลูกโซ่

อาการที่พบในงานจริง

ในการสั่งเอเจนต์ทำงานลูกโซ่ 5 ขั้นตอน ในก้าวที่ 1 เกิดความผิดพลาดเพียงเล็กน้อย 2% แต่ก้าวที่ 2 ดึงผลลัพธ์นั้นไปต่อ ก้าวที่ 3 คลาดเคลื่อนเพิ่ม จนถึงก้าวที่ 5 ระบบพังทลายโดยสิ้นเชิง

สูตรคำสั่งป้องกัน
[ด่านตรวจทุกขั้นตอนย่อย]
หลังจากเสร็จแต่ละขั้นตอนย่อย:
- ต้องแสดงผลตรวจผ่าน/ไม่ผ่านก่อนเสมอ
- ห้ามเริ่มขั้นตอนถัดไป หากขั้นตอนก่อนหน้ายังมีความคลาดเคลื่อน
แนวทางตรวจรับงาน: วางจุดตรวจกั้นทั้งข้อมูลเข้าและข้อมูลออกทุกจุดเชื่อมต่อของลำดับงาน
BH-29 จิตวิทยาโมเดล
อคติทางความคิด

29. ลำเอียงตามลำดับตัวเลือก (Order Bias)

เลือกข้อแรกหรือข้อสุดท้ายบ่อยกว่าข้อกลาง

อาการที่พบในงานจริง

เมื่อให้ตัวเลือกช้อยส์ ก, ข, ค, ง หรือตัวเลือกที่ 1, 2, 3 AI มักมีอคติทางสถิติเลือกข้อแรกหรือข้อสุดท้ายบ่อยกว่าข้อกลางๆ เสมอ

สูตรคำสั่งป้องกัน
[ประเมินโดยไม่ยึดลำดับ]
ประเมินตัวเลือกแต่ละข้อโดยอิสระจากลำดับการจัดวาง
- เขียนแจกแจงข้อดีข้อเสียของแต่ละตัวเลือกก่อนระบุข้อสรุป
- ห้ามตัดสินใจโดยอิงจากตำแหน่งบนสุดหรือล่างสุด
แนวทางตรวจรับงาน: สลับลำดับตัวเลือกแล้วถามซ้ำ เพื่อดูว่าคำตอบยังคงเดิมหรือไม่
BH-30 จิตวิทยาโมเดล
อคติทางความคิด

30. อคติจากการจัดกรอบคำถาม (Framing & Anchoring Effect)

คำตอบเอนไปตามกรอบหรือน้ำเสียงของคำถาม

อาการที่พบในงานจริง

แม้โจทย์เชิงตรรกะจะเหมือนกันทุกประการ แต่หากเริ่มต้นประโยคด้วยกรอบคิดเชิงลบ ความกลัว หรือน้ำเสียงชี้นำ คำตอบของ AI จะเทน้ำหนักไปตามกรอบนั้นทันทีอย่างไม่เป็นกลาง

สูตรคำสั่งป้องกัน
[วิเคราะห์อย่างเป็นกลาง]
วิเคราะห์โจทย์นี้จากข้อเท็จจริงทางสถิติและวิศวกรรมเท่านั้น
- ละทิ้งกรอบอารมณ์หรือน้ำเสียงชี้นำของผู้ถามทั้งหมด
- ให้คะแนนเปรียบเทียบตามเกณฑ์ชี้วัดที่เป็นมาตรฐานเท่านั้น
แนวทางตรวจรับงาน: ตรวจทานว่าผู้สั่งไม่ได้สอดแทรกอคติส่วนตัวลงในประโยคคำถาม